产品实拍
真实界面,真实数据
以下截图全部取自演示环境,数据来自合成的「明州控股集团」演示库。
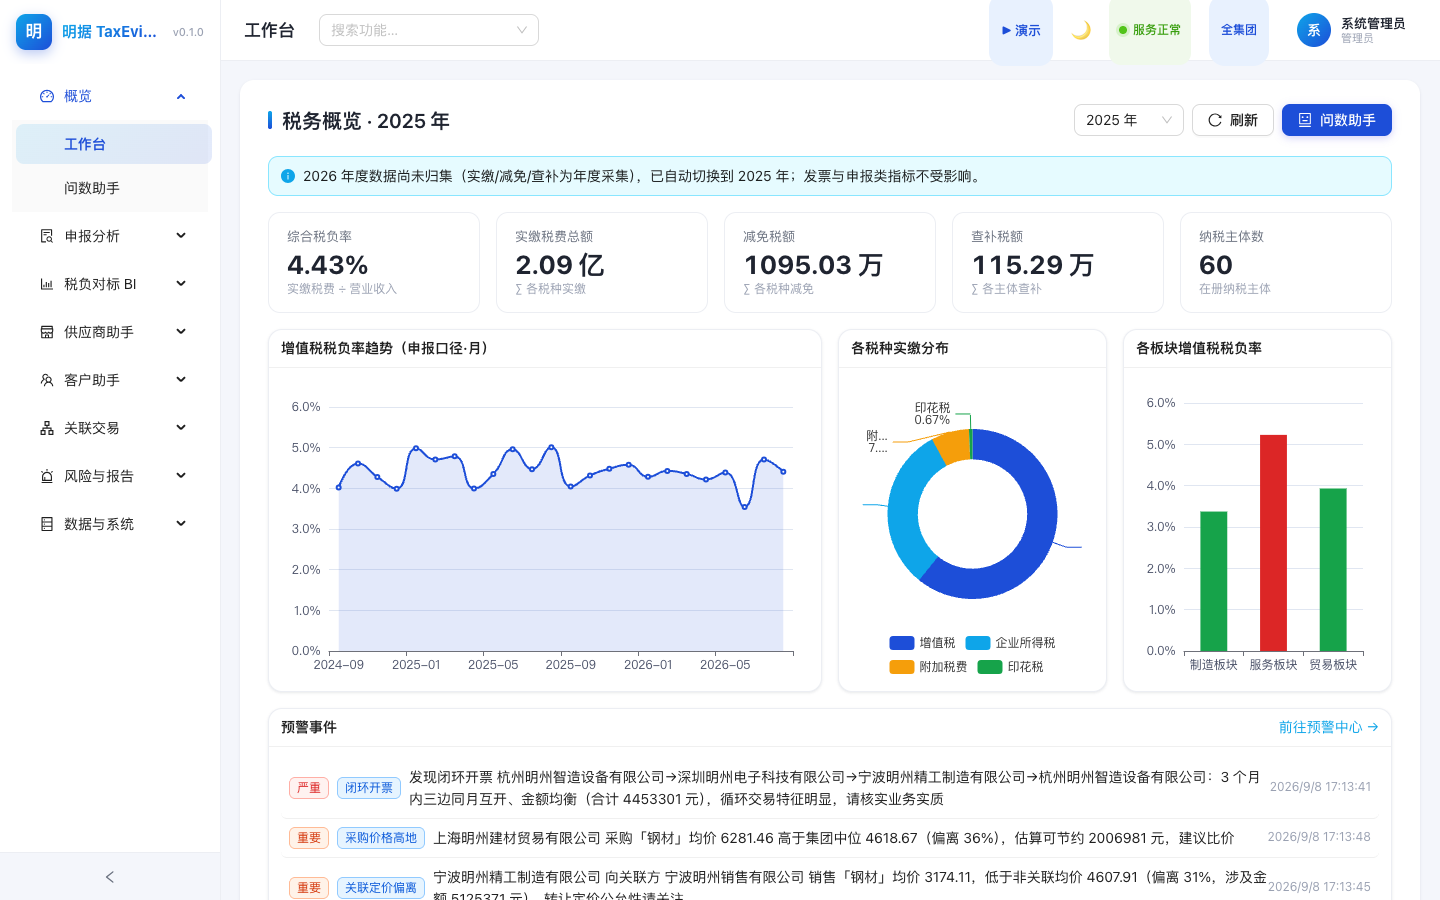
工作台:五项 KPI、税负趋势、税种分布、板块对比与最新预警
这三条不是我们想出来的,是需求调研里逐条记下来的。
票、表、缴、免分散在各子公司的系统里,口径还不一致。想看全集团上个月的增值税税负率, 得等各家报上来,报上来的口径还得再对一遍。
异常藏在几十万张发票里。循环开票、关联方低价、优惠悄悄断了——靠人抽查, 发现时往往已经过了自查窗口。
数据只用来报税,报完就躺在库里。同样一批发票,其实能看出哪里采购买贵了、 哪个客户要流失了、关联定价偏到什么程度。
不是功能罗列,是一条从「有数」到「有用」的路。
把口径统一的指标摆上台面,全集团一屏可见。
税负变了,能说清楚是什么因素、贡献多少。
风险主动找上门,并且走完处置闭环留痕。
让税务数据反过来支持业务与决策。
覆盖需求方案的 16 个应用场景。菜单里没有一个「建设中」的占位页——全部已交付。
以下截图全部取自演示环境,数据来自合成的「明州控股集团」演示库。
工作台:五项 KPI、税负趋势、税种分布、板块对比与最新预警
所以我们把几条规矩写成了代码红线,不是文档里的倡议,是提交前会被拦下来的约束。
归因、排名、金额只能来自工具查询返回,提示词里明令禁止估算。 模型负责把因素写成人话,数字由引擎产出。
模型只能调用参数化的语义工具,指标、维度、期间都是枚举参数。 既防注入,也保证 AI 的口径与看板完全一致。
所有文案只用「提示 / 关注 / 偏离」,禁止出现违法或虚开定性字样。 每条预警必须带证据:票号、行次、数值、阈值。
税负率区分「实缴口径」与「应纳(申报)口径」,接口与页面都带 basis 字段。
比率指标分子分母分开存,组织汇总先加总再求比。
授权范围外一律不可见。遇到无法按范围重算的集团级口径(如 CR/HHI), 系统明确拒绝并说明原因——给一个分母错的数字比拒绝更危险。
阈值、指标定义、评分卡权重全在 rules/*.json。政策变了改配置不改代码,
用统计方法(IQR / Z 分数 / 回归)而非黑箱模型。
怎么证明这些分析模型真的能抓到问题?我们在演示库里主动埋了异常,然后让系统去找。
合成的「明州控股集团」演示库,全部经导入 API 写入(顺带验证了导入器本身)。 我们在里面预埋了 12 类典型税务异常,每次发版必须跑一次核对, 15 项断言全部 PASS 才算通过——也就是每一个能力都有可验证的演示,而不是"我们支持这个功能"。
AI 问数另有 30 道题的评测集,断言「期望工具被调用」+「答案含 golden SQL 现算的数字」,目前 30/30 通过。